در حالی که صحبت از پیشرفتهای خیرهکنندهی هوش مصنوعی میشود، ناگهان نام «واحد پردازش عصبی» یا NPU بر سر زبانها میافتد. اما NPU دقیقاً چیست و چرا سر و صدا به پا کرده است؟ در این مقاله، قصد داریم به زبان ساده، از صفر تا صد این فناوری، تفاوت آن با پردازندههای رایج و آیندهای که برای دستگاههای هوشمند رقم خواهد زد، بپردازیم.
واحد پردازش عصبی (NPU) چیست؟
NPU مخفف عبارت Neural Processing Unit و به عنوان یک «واحد پردازش تخصصی در تراشههای مدرن تعبیه میشود. این واحد، به طور خاص برای اجرای وظایف مرتبط با هوش مصنوعی و یادگیری ماشین طراحی شده است.» اما چرا چنین واحدی نیاز است؟ برای پاسخ به این سوال، ابتدا باید نگاهی به قابلیتهای فنی هر کدام از این واحدها بیندازیم.
NPU در مقابل CPU و GPU: مقایسه دقیق
برای درک بهتر، جدول زیر مقایسهی دقیقی از عملکرد و کاربرد هر کدام ارائه میدهد:
| ویژگی ها | CPU (واحد پردازش مرکزی) | GPU (واحد پردازش گرافیکی) | NPU (واحد پردازش عصبی) |
|---|---|---|---|
| معماری | چند هستهی قوی برای کارهای پشت سر هم (Sequential) | هزاران هستهی کوچک برای کارهای موازی (Parallel) مثل 3D Design | هستههای تخصصی برای «تنسور» و «ماتریس» (Matrix/Tensor) |
| وظیفه اصلی | مدیریت کل سیستم و اجرای دستورات عمومی (General Purpose) | رندرینگ گرافیکی و تسریع پردازش تصویر | تسریع محاسبات هوش مصنوعی (شبکههای عصبی) |
| مزیت کلیدی | انعطافپذیری بالا، قوی در پردازشهای منطقی | توان عملیاتی موازی فوقالعاده برای ریاضیات سنگین | بهره وری انرژی فوقالعاده (Performance per Watt) و سرعت بالا در عملیات تکراری |
| محدودیت | برای شبکههای عصبی عمیق، کند و پرمصرف | مصرف انرژی بالا، مناسب نبودن برای شاخهها و حلقههای شرطی | انجام فقط کارهای هوش مصنوعی؛ انعطافپذیری کم برای سایر وظایف |
مزایای بارز ان پی یو NPU
-
سرعت فوقالعاده: NPUها برای انجام عملیاتِ تکراری و جبرخطی (Linear Algebra) و ماتریسی که پایه و اساس یادگیری ماشین هستند، بهینه شدهاند. این کار را با سرعتی بسیار بیشتر از CPU و با کارایی بالاتر از GPU انجام میدهند.
-
بهره وری انرژی شگفتانگیز: مهمترین مزیت NPUها، نسبت عملکرد به توان (Performance per Watt) است. آنها میتوانند با مصرف انرژی بسیار کمتر، کار هوش مصنوعی را انجام دهند. این یعنی شارژدهی بیشتر در لپتاپها و تبلتها.
-
حریم خصوصی (Privacy): با انجام پردازشها بر روی خودِ دستگاه (On-Device)، نیازی به ارسال دادههای حساس شما (مثل تصاویر، صداها و اطلاعات شخصی) به سرورهای ابری نیست. این مزیت بزرگ NPUها در دنیای امروز است.
-
کاهش تاخیر (Latency): از آنجایی که دادهها برای پردازش به سرورهای دور دست فرستاده نمیشوند، پاسخدهی برنامهها در لحظه (Real-time) انجام میشود. این موضوع برای کاربردهایی مثل ترجمه زنده یا واقعیت افزوده حیاتی است.
کاربردهای متنوع NPU در زندگی روزمره
امروزه NPUها در قلب دستگاههای هوشمند ما جای گرفتهاند و کاربردهای وسیعی دارند:
-
دستگاههای هوشمند: ویرایش حرفهای عکس و فیلم، حذف اشیاء و تغییر پسزمینه در لحظه.
-
اینترنت اشیاء (IoT): در دوربینهای مداربسته، حسگرهای صنعتی و لوازم خانگی هوشمند برای پردازش هوشمند دادهها بدون نیاز به ابر.
-
خودروهای خودران: برای تشخیص هویت عابران پیاده، علائم رانندگی و مسیرهای جادهای در کسری از ثانیه.
-
تشخیص چهره و صدا: باز کردن قفل دستگاه (مثل Face ID در آیفون) یا احراز هویت صوتی.
-
پردازش زبان طبیعی (NLP): کارهایی مثل ترجمه همزمان، خلاصهسازی متون و پاسخ به دستیارهای صوتی مثل سیری یا الکسا با سرعت بالا.
واحد پردازش تنسور (TPU) چیست؟
واحد پردازش تنسور (Tensor Processing Unit یا TPU) یک مدار مجتمع ویژه (ASIC) است که توسط گوگل برای تسریع یادگیری ماشین و شبکههای عصبی طراحی شده است. اولین بار در سال ۲۰۱۵ معرفی شد و اکنون ستون فقرات بسیاری از سرویسهای گوگل مانند Search، Street View، Google Photos و Google Translate را تشکیل میدهد. در اصل TPU یک پردازنده انحصاری گوگل برای انجام محاسبات عظیم هوش مصنوعی در بستر ابری و مراکز داده است که با معماری سیلیکونی خاص خود، عملیات جبرخطی (Linear Algebra) را با سرعت و کارایی مثالزدنی انجام میدهد.
معماری TPU
معماری TPU بر پایه پردازش حجم بالایی از محاسبات با دقت پایین (Low Precision) و تعداد عملیات ورودی/خروجی بالا به ازای هر ژول انرژی طراحی شده است:
-
واحد ضرب ماتریس (Matrix Multiplication Unit): مغز متفکر TPU که عملیات ضرب ماتریسی عظیم و موازی را در مقیاس کلان انجام میدهد.
-
بافر یکپارچه (Unified Buffer): حافظه محلی روی تراشه برای ذخیره موقت دادهها و کاهش وابستگی به حافظه خارجی.
-
واحد کنترل (Control Unit): هماهنگی حرکت دادهها بین بخشهای مختلف تراشه.
نکته مهم اینکه TPU فاقد سختافزار rasterisation/texture mapping است؛ زیرا برای پردازش گرافیکی طراحی نشده، بلکه صرفاً برای شبکههای عصبی ساخته شده است.
TPU در مقابل GPU: رقابت در مراکز داده
تحقیقات گوگل نشان میدهد که TPUها عملکردی ۱۵ تا ۳۰ برابر بهتر از پردازندهها و کارتهای گرافیک همدوره خود دارند و در عین حال ۳۰ تا ۸۰ برابر بازدهی بیشتری به ازای هر وات انرژی مصرفی ارائه میدهند. نسلهای جدید TPU گوگل (مانند نسل هشتم TPU 8t برای آموزش و TPU 8i برای استنتاج) با هزینه کمتر و تأخیر تقریباً صفر، قدرت بینظیری در اختیار شرکتها قرار میدهند. البته GPUها همچنان برای برخی شبکههای عصبی کاملاً متصل (Fully Connected Networks) مزایایی دارند و CPUها برای شبکههای بازگشتی (RNN) مناسبتر هستند.
محدودیتهای TPU
TPUها یک اشکال بزرگ دارند: محصور بودن در اکوسیستم گوگل. این پردازندهها عمدتاً برای فریمورکهای TensorFlow، JAX و PyTorch بهینه شدهاند و انعطاف چندانی برای استفاده خارج از این اکوسیستم ندارند.
واحد پردازش داده (DPU) چیست؟
واحد پردازش داده (Data Processing Unit یا DPU) یک پردازنده نوظهور است که توسط انویدیا (NVIDIA) در سال ۲۰۲۰ معرفی شد و بهسرعت به عنوان سومین رکن اصلی محاسبات مدرن، در کنار CPU و GPU، مطرح شده است. جنسن هوانگ، مدیرعامل انویدیا، سه پایه اصلی محاسبات را اینگونه توصیف میکند: «CPU برای محاسبات عمومی، GPU برای محاسبات شتابیافته، و DPU برای جابجایی و پردازش داده در مرکز داده».
چرا به DPU نیاز داریم؟
دادههای مدرن با سرعتی بسیار فراتر از توان پردازشی CPU در حال رشد هستند. پردازش امنیت، ارتباطات، ذخیرهسازی و مجازیسازی توسط CPU به یک تنگنای جدی در مراکز داده تبدیل شده است. وظایف زیرساختی مانند IPsec، TLS، AES-GCM، NVMe-oF، RAID، RDMA و VXLAN تا یکسوم از چرخههای پردازشی CPU را مصرف میکنند.
معماری و عملکرد DPU
DPU از سه بخش اصلی تشکیل شده است:
| مؤلفه | نقش کلیدی |
|---|---|
| هستههای ARM CPU | پردازش وظایف مدیریت و کنترل (Control Plane) |
| شتابدهندههای سختافزاری اختصاصی | اجرای وظایف امنیتی، ذخیرهسازی و شبکه با حداکثر سرعت |
| رابط شبکه پرسرعت (SmartNIC) | اتصال به شبکه با پهنای باند ۴۰۰ گیگابیت بر ثانیه |
با این طراحی، DPUها میتوانند بار زیرساختی را از دوش CPU بردارند و CPU را برای اجرای برنامههای اصلی و تولید درآمد آزاد کنند. برای نمونه، یک DPU BlueField-3 قادر است خدماتی معادل ۳۰۰ هسته CPU را ارائه دهد و رمزگذاری IPSec را ۱۵۰ برابر سریعتر و عملیات ورودی/خروجی ذخیرهسازی را ۳۰ برابر چابکتر انجام دهد.
کاربردهای مهم DPU
| حوزه | کاربرد کلیدی |
|---|---|
| ابر مقیاس بزرگ | مجازیسازی، محفظههای کاری (Containerized Workloads) و استنتاج هوش مصنوعی |
| امنیت سایبری | تشخیص نفوذ همزمان (Real-time IDS)، فایروال و رمزنگاری |
| مخابرات و 5G | ارتباطات فوقکمتأخیر و پهنای باند بالا برای نسل بعدی شبکهها |
| هوش مصنوعی و HPC | شبیهسازی کلان، آموزش کارآمد مدلهای عظیم و AI-RAN ( شبکه دسترسی رادیویی مبتنی بر هوش مصنوعی) |
| محاسبات لبه (Edge Computing) | پردازش داده و امنیت در لبه شبکه برای اینترنت اشیاء و صنعت |
TPU در مقابل NPU در مقابل DPU: جمعبندی سهگانه
در حالی که NPU را قبلاً به عنوان واحد پردازش عصبی برای وظایف هوش مصنوعی در لبه (مانند تشخیص چهره در گوشی و ترجمه زنده در لپتاپ) معرفی کردیم، حالا به راحتی میتوان جایگاه هر سه را در کنار هم دید:
| ویژگی | NPU | TPU | DPU |
|---|---|---|---|
| توسعهدهنده اصلی | اپل، کوالکام، مدیاتک، هواوی | گوگل (انحصاری) | انویدیا (و سایرین) |
| محل استفاده | لبه (گوشی، لپتاپ، IoT) | مرکز داده ابری گوگل | مرکز داده، شبکه، لبه |
| وظیفه اصلی | AI روی دستگاه: تشخیص چهره، سیری، عکاسی محاسباتی | آموزش و استنتاج عظیم هوش مصنوعی در ابر | زیرساخت داده: شبکه، امنیت، ذخیرهسازی |
| معیار قدرت | TOPS (تریلیون عملیات در ثانیه) | TOPS، ترابایت بر ثانیه حافظه | پهنای باند (۴۰۰ گیگابیت بر ثانیه) و نرخ بسته |
| انعطافپذیری | بالا (طراحی برای کارهای AI متنوع) | پایین (بهینه برای TensorFlow/JAX) | بالا (قابل برنامهریزی با DOCA) |
| نمونه بارز | Apple Neural Engine | Ironwood, TPU v8i | NVIDIA BlueField-3 |
یک نگاه کلی: اکوسیستم پردازندههای تخصصی
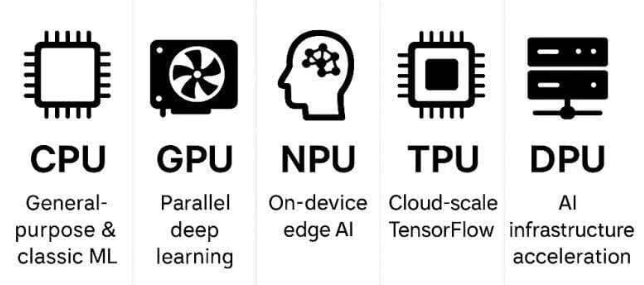
این روزها دیگر خبری از «یک پردازنده برای همه کارها» نیست. صنعت قطعات، به سمت محاسبات ناهمگون (Heterogeneous Computing) حرکت میکند؛ جایی که قطعات مختلف (CPU، GPU، NPU، TPU و DPU) هر کدام بهترین کاری را که بلد هستند، انجام میدهند. در عمل، یک زیرساخت هوش مصنوعی مدرن (چه در ابر و چه در لبه) از ترکیب CPU + GPU + DPU استفاده میکند و بسته به نیاز، NPU یا TPU نیز به آن افزوده میشود تا کارایی، مصرف انرژی و تأخیر بهینهای داشته باشد.
در جدول زیر مقایسهای کلی از مهمترین واحدهای پردازشی را مرور میکنیم:
| نوع پردازنده | وظیفه اصلی | نقاط قوت | نقاط ضعف |
|---|---|---|---|
| CPU | محاسبات عمومی، مدیریت سیستم | انعطافپذیر، توان منطقی بالا | کارایی پایین در موازیسازی و هوش مصنوعی |
| GPU | گرافیک، موازیسازی گسترده | قدرت موازیسازی بالا برای رندر و یادگیری عمیق | مصرف انرژی بالا، هزینه زیاد |
| NPU | هوش مصنوعی در لبه با مصرف بهینه | بهرهوری انرژی بالا برای وظایف AI | انعطاف کم در کاربردهای غیر AI |
| TPU | آموزش و استنتاج انبوه مدلهای AI در ابر گوگل | توان عملیاتی و بازدهی انرژی بسیار بالا و بهینه | کاملاً وابسته به اکوسیستم گوگل |
| DPU | پردازش زیرساخت داده (شبکه، امنیت، ذخیرهسازی) | آزادسازی CPU، امنیت بالاتر، پهنای باند عظیم | هزینه بالا، کاربرد محدود به سناریوهای زیرساختی |
بازیگران اصلی میدان رقابت NPU : اپل، اینتل، AMD و کوالکام
این فناوری انحصاری نیست و تمام غولهای فناوری به دنبال بهینهسازی NPU در محصولات خود هستند. برای مقایسه بهتر، جدول زیر را ببینید:
| شرکت/تراشه | نام NPU | حداکثر قدرت پردازش (TOPS) | معماری/تکنولوژی | کاربرد اصلی | نکات قابل توجه |
|---|---|---|---|---|---|
| اپل Apple M4 | موتور عصبی (Neural Engine) | 38 TOPS | نسل دوم 3 نانومتری TSMC | آیپد پرو، مک بوکها، دستگاههای حرفهای | 60 برابر سریعتر از A11؛ یکی از قدرتمندترین NPUهای یکپارچه |
| کوالکام Snapdragon X Elite | Hexagon NPU | 45 TOPS | ARM v8.7، تا 4.3 گیگاهرتز | لپتاپهای ویندوزی Copilot+ PC | سریعترین در لپتاپها برای هوش مصنوعی مولد |
| اینتل Intel Lunar Lake (Core Ultra 200V) | NPU4 | 40-48 TOPS | 3 نانومتری، حافظه یکپارچه LPDDR5x (16/32GB) | لپتاپهای AI (Copilot+ PC) | تمرکز بر بهینهسازی مصرف انرژی (تا 40 درصد کاهش مصرف) |
| AMD Ryzen AI 400 Series | XDNA 2 | 50-60 TOPS | 4 نانومتری (و احتمالاً پیشرفتهتر) | لپتاپهای حرفهای، دسکتاپ، حتی کنسولهای قابل حمل | یکی از بالاترین TOPS در بین x86ها؛ مناسب برای کارهای سنگین AI |
| مدیاتک (MediaTek) | واحد پردازش عصبی | نمیدانم | معمولاً 4 یا 3 نانومتری | گوشیهای هوشمند، تبلتها، تراشههای Dimensity | در گوشیهای پرچمدار اندرویدی حضور پررنگی دارد |
توضیحات:
-
TOPS: مخفف Trillion Operations Per Second (میلیاردها عملیات در ثانیه) است. هر چه این عدد بالاتر باشد، پردازنده در انجام محاسبات هوش مصنوعی قویتر است.
-
هوش مصنوعی مولد (Generative AI): توانایی NPU در اجرای مدلهای زبانی بزرگ (LLM) مانند GPT-4o به صورت محلی بدون نیاز به اینترنت (مثل کامپیوترهای جدید Copilot+ PC) است.
آیندهی پیش رو: سرورهای ابری، لبه (Edge) یا ترکیبی؟
این سوال بزرگ، آیندهی فناوری اطلاعات را به دو نیمه تقسیم کرده است: Cloud (ابر) در مقابل Edge (لبه).
ابر (Cloud): خانهٔ مدلهای عظیم
-
مزایا: قدرت محاسباتی نامحدود و دسترسی به جدیدترین و بزرگترین مدلهای هوش مصنوعی با قابلیت همکاری میلیونها کاربر.
-
معایب: وابستگی مطلق به اینترنت پرسرعت (latency بالاست)، هزینهی سرور و نگهداری بالا، و مهمتر از همه، نگرانیهای جدی امنیتی و حریم خصوصی.
لبه (Edge): هوشمندی درون دستگاه
-
مزایا: حریم خصوصی مطلق (دادهها خارج نمیشوند)، عملکرد در لحظه (Real-time)، بدون نیاز به اینترنت مداوم و مصرف انرژی بهینه. ( رایانش لبه (Edge Computing) چیست؟رایانش لبه (Edge Computing) یک مدل پردازش غیرمتمرکز است که دادهها را در نزدیکی منبع تولیدشان، در دستگاههایی مانند دروازههای هوشمند، سرورهای محلی یا خود دستگاههای IoT پردازش میکند. در مقابل، رایانش ابری (Cloud Computing) مدلی است که در آن دادهها به مراکز دادهی عظیم و متمرکز در نقاط دور دست ارسال و پردازش میشوند.)
-
معایب: دستگاهها به NPUهای قدرتمند نیاز دارند (که قیمت را بالا میبرد)، حافظه و قدرت پردازش محدودتری نسبت به ابر دارند و برای بهروزرسانی باید دستگاه عوض کنید.
آینده: یک اکوسیستم ترکیبی (Hybrid)
به نظر نمیرسد ابر به طور کامل کنار گذاشته شود یا بالعکس. آینده در یک معماری هوشمند ترکیبی (Hybrid AI) نهفته است. در این معماری، دستگاههای لبه (ادج) کارهای سادهتر و حساس به حریم خصوصی (مثل تشخیص چهره، ترجمه زنده) را بر عهده میگیرند و وظایف فوقالعاده سنگین و پیچیده (مثل مدلسازی مولکولی، تحلیل کلان داده) به ابر واگذار میشود. این توزیع هوشمندانه، بهترین مزایای هر دو جهان را یکجا ارائه میدهد.
چرا یک پردازنده قدرتمند برای همه چیز کافی نیست؟ معماری Chiplet و تخصصگرایی
شاید بپرسید: «چرا مثل فیلمهای علمی-تخیلی، یک پردازندهی مرکزی (Central Processor) همهکاره نداریم که همزمان گرافیک بازی را بزند، هوش مصنوعی را اجرا کند و با کمترین مصرف انرژی هم کار کند؟» پاسخ در تخصصگرایی نهفته است. در معماریهای مدرن، ما از معماری Chiplet استفاده میکنیم.
به جای یک الماس بزرگ و گرانقیمت که باید همهی کارها را با کیفیت متوسط انجام دهد، تراشهها را به صورت قطعات کوچکتر و تخصصی (Chiplet) تولید میکنیم:
-
یک Chiplet برای CPU (کارهای عمومی)،
-
یک Chiplet برای GPU (گرافیک و رندر)،
-
یک Chiplet یا بخشی برای NPU (هوش مصنوعی).
این قطعات در کنار هم روی یک بستر قرار میگیرند و به صورت یکپارچه کار میکنند. این روش باعث کاهش هزینهی تولید، افزایش سرعت توسعه و بهینهسازی عملکرد در هر حوزه میشود. بنابراین، به جای یک پردازندهی «همه چیزدان»، آینده از آنِ پردازندههای همه چیز در یک (All-in-One) با ماژولهای تخصصی است.
نگاهی به آینده: گجتهای هوشمند، موبایل و لپتاپها تا سال 2030
حالا که با اصول پایه آشنا شدیم، بیایید نگاهی به آیندهای که این فناوری برای ما رقم خواهد زد، بیندازیم:
-
ردهبندی قدرت (TOPS) به سرعت افزایش مییابد: در سالهای 2024-2025، ردهی 45 تا 50 TOPS استاندارد اصلی شد. اما اینتل در نسلهای بعدی خود (Nova Lake + NPU6) هدف را روی 74 TOPS گذاشته است و کوالکام نیز اسنپدراگون X2 Elite را با 80 TOPS عرضه کرده است. رقابت برای رسیدن به «ابرقدرت هوش مصنوعی» درون دستگاهها شعلهور است.
-
اندازه و مصرف انرژی: با حرکت به سمت لیتوگرافی 1 نانومتری و فناوریهای جدید مثل GAAFET (ترانزیستورهای گیت فراگیر)، NPUها بسیار کوچکتر و کممصرفتر خواهند شد. این یعنی تا سال 2030، یک گوشی هوشمند با مصرف کمتر از 1 وات، قادر به اجرای مدلهای هوش مصنوعی در سطح GPT-3 خواهد بود.
-
حافظهی یکپارچه (Unified Memory) و پهنای باند بالا: مدلهای بزرگ هوش مصنوعی به حافظهی بسیار سریع و پهنای باند بالا نیاز دارند. حافظههای HBM (حافظه با پهنای باند بالا) و LPDDR6 به عنوان بخشی از تراشه (SoC) یکپارچه میشوند تا دادهها با کمترین تاخیر جابجا شوند.
-
کاربردهای جدید انقلابی:
-
موبایل و تبلت: ترجمهی همزمان مکالمات تلفنی و تشخیص سرطان از طریق تصاویر پزشکی گرفته شده با دوربین گوشی.
-
لپتاپ: دستیارهای هوش مصنوعی کاملاً آفلاین که تمام تاریخچه و فایلهای شخصی شما را میشناسند، برایتان ایمیل مینویسند و کد برنامهنویسی میزنند. لپتاپهای Copilot+ PC مایکروسافت نمونههای اولیه این آینده هستند.
-
اینترنت اشیاء (IoT): حسگرهایی که خطر آتشسوزی یا نشت گاز را قبل از وقوع تشخیص میدهند، چراغهای خیابانی که بر اساس تردد عابران روشن و خاموش میشوند و سیستمهای کشاورزی دقیق (Precision Agriculture) که نیاز آبی هر بوته را در لحظه محاسبه میکنند.
-
دستیارهای فراگیر (Ambient Assistants): عینکها و هدستهای واقعیت افزوده (AR) که افراد و اشیاء را در لحظه شناسایی کرده و اطلاعات مفید (مانند نام افراد، مشخصات محصولات) را روی میدان دید شما نمایش میدهند.
-
آیندهی تراشههای هوش مصنوعی: مقیاسپذیری و هوشمندی (Apple Intelligence & Beyond)
انتظار میرود با ظهور استانداردهای جدیدی مثل «Apple Intelligence» در محصولات اپل و «Windows Copilot+ » در کامپیوترهای شخصی، نقش NPUها بیش از پیش پررنگ شود. پیشبینی میشود که تا سال 2030:
-
بیش از 90 درصد گوشیهای هوشمند و تمام لپتاپهای جدید به NPU مجهز شوند.
-
قدرت NPUها از صدها تاپس (hundreds of TOPS) عبور کند و اجرای مدلهای هوش مصنوعی به صورت لحظهای و بدون تاخیر انجام شود.
سخن پایانی: عصر جدیدی از محاسبات
NPUها فقط یک تراشهی اضافه نیستند؛ بلکه پاسخی به نیاز روزافزون به کارایی محلی، امنیت بالاتر و مصرف بهینه در عصر هوش مصنوعی هستند. همان طور که GPU ها انقلابی در گرافیک و بازیها ایجاد کردند، NPUها نیز عصر جدیدی از محاسبات را رقم خواهند زد. درک تفاوتهای تخصصی بین CPUها، GPUها و NPUها به شما کمک میکند تصمیمات بهتری برای خرید لپتاپ، گوشی یا تبلت بعدی خود بگیرید.
امیدواریم این راهنمای جامع برای شما مفید بوده باشد. اگر سوال یا نظری دارید، خوشحال میشویم در بخش دیدگاهها با ما به اشتراک بگذارید!